Die Versicherungsbranche setzt zunehmend auf autonome KI-Agenten und Versicherer testen immer mehr Agentic AI Use Cases. Bisher kommen dabei ausschließlich LLMs zum Einsatz. Nun hat das KI-Lab TypeSafe1 am 15. September 2026 ein spezialisiertes Modell veröffentlicht (Jev), welches allgemeine LLMs bei konkreten Aufgaben ersetzen könnte. Jev setzt auf schnelles, deterministisches Routing und ist ein Entscheidungsmodell, das in unterschiedlichen Versicherungsdomänen eingesetzt werden kann. Es eignet sich vor allem für Sachverhalte, in denen Klassifikation, Priorisierung sowie Erkennung eine Rolle spielen. Die großen Unterschiede zu LLMs sind:
- Jev erzeugt keine Texte,
- führt keine Dialoge,
- nutzt kein Chain-of-Thought-Reasoning.
Das Modell funktioniert wie folgt: Man übermittelt einen Text samt vorab definierten Antworten und Jev bewertet den Text und übermittelt in seiner Antwort ein Entscheidungsergebnis. Versicherer sollten jetzt prüfen und testen, wo Jev in ihre agentischen KI-Workflows eingebaut werden kann, um die Kosten von deterministischen Zwischenabfragen senken zu können. Wichtig zu beachten ist, dass Jev mittels englischer Sprache trainiert wurde und die Genauigkeit daher im Englischen derzeit am höchsten ist. Andere Sprachen werden zwar unterstützt, sind aber weniger gut – ein deutscher Benchmark ist nicht veröffentlicht.
Per 1. Oktober 2026 beschriebt OpenAI eine begrenzte Vorschau seiner Decisions API, die kein Anfrageschema angibt.2 Der für die Aktualisierung des Posts geprüfte
Leitfaden sagt, die API sei in der öffentlichen Beta. Das Modell ist gpt-6-luna. Der Endpunkt ist POST /v1/decisions. Die Eingabe kostet 0,10 USD je Million Token, Ausgabe-Token werden nicht abgerechnet.
Dieselbe Seite nennt regionale Verarbeitungszuschläge und Multiplikatoren für langen Eingabe-Kontext.
- Jev ist ein nicht-generatives System-One-Entscheidungsmodell, das speziell für Klassifizierung, Priorisierung und Erkennung in agentischen Workflows entwickelt wurde.
- Im Gegensatz zu LLMs liefert es drei vorhersehbare Primitive: Choice (Kategorisierung), Score (Triage) und Noul (Ja-Wahrscheinlichkeit).
- Es ist äußerst kostengünstig und arbeitet im Subsekundenbereich, wodurch es ideal in der Underwriting-Triage (z.B. Erkennung von Ausschlüssen) und dem Schaden-Routing (z.B. FNOL-Warteschlangen-Priorisierung) eingesetzt werden kann.
- Jev ist in Englisch am genauesten, andere Sprachen werden unterstützt, sind aber weniger gut. Ein deutscher Benchmark ist nicht veröffentlicht.
Inhaltsverzeichnis
Inhaltsverzeichnis öffnen
- Wie Agentic AI in der Versicherungsbranche Jevs drei Primitive nutzen kann
- Fazit
- FAQ
- Wer hat Jev entwickelt?
- Was ist Jev?
- Was ist der State?
- Was gibt jedes Primitiv zurück?
- Worin unterscheiden sich Jev und LLMs in Versicherungs-Workflows grundlegend?
- Welches sind die wichtigsten Agentic-AI-Anwendungsfälle für Jev in der Versicherungsbranche?
- Welche Kontrollen des operationellen Risikos sind nötig, wenn Versicherungsvorgänge an Jev delegiert werden?
- Ist Jev in allen Sprachen gut?
- Wie sichert man die Prüfbarkeit und senkt das allgemeine Risiko beim Einsatz von Jev in der Versicherung?
- Quellen
Wie Agentic AI in der Versicherungsbranche Jevs drei Primitive nutzen kann
Jev gibt keinen Fließtext zurück, sondern drei Primitive, also drei Antworttypen:
- Choice (Auswahl - wählt eine Option aus einer definierten Liste)
- Score (Bewertung - bewertet einen Zustand auf einer geordneten Skala)
- Noul (Wahrheitswert - schätzt die Wahrscheinlichkeit einer Ja/Nein-Aussage)
Ein Aufruf über die Jev-API hat drei Felder: state, model und questions. Der State ist der Text, den Jev beurteilt. Das kann ein String sein, ein JSON-Objekt oder ein Array aus Texten.
Die Questions sind ein eigenes Feld und unten folgt für jedes Primitiv ein konkretes Beispiel. Alle Anfragen sind gültige Aufrufe direkt im Playground von TypeSafe
mit Jev in der Version 1.13 (typesafe/jev-1.13). Die Zahlen stammen aus den Live-Abfragen und können sich von Aufruf zu Aufruf etwas unterscheiden.
- Choice ist die Nutzungsart einer Gewerbeimmobilie.
- Score ist die Reihenfolge, in der die Schadenbearbeitung eine Erstmeldung aufgreifen sollte.
- Noul ist ein Zeichnungsausschluss.
Choice: Nutzungsart einer Gewerbeimmobilie kategorisieren
Das Primitiv "Choice" liefert die ausgewählte Option, eine Wahrscheinlichkeitsverteilung für alle übermittelten Optionen sowie einen Konfidenzwert als Ergebnis. Der Konfidenzwert gibt an, wie konzentriert die Verteilung ist.
Das Beispiel stammt aus der gewerblichen Sachversicherung und zeigt die Abfrage der Nutzungsart, die in einer Submission enthalten ist.
Der State enthält ausschließlich die Betriebsbeschreibung. Die Optionen sind eine kurze Liste, gegen die ein Versicherer dieses Gebäude tarifieren könnte.
Dazu gehören der Laden, die Büros sowie fünf weitere Betriebsarten und zusätzlich die Werte other und not_stated, also insgesamt neun Listenelemente.
Das stellt selbstverständlich kein vollständiges Tarifwerk dar, reicht aber aus, um das Grundprinzip zu verdeutlichen. Aufgrund der Modellbegrenzung muss ein
vollständiges Tarifwerk aber in maximal 255 Optionen (Listenelemente) passen, und außerdem die beiden Auffangpositionen other und not_stated enthalten.
Anfrage und Antwort
Die folgende Eingabe ist ein Textbeispiel aus einer E-Mail-Submission eines Maklers oder Antragstellers. Da Jev vornehmlich mit englischer Sprache trainiert ist und die Genauigkeit bezüglich englischem Text derzeit am höchsten ist, habe ich diesen Text verwendet.
Eingabe
State:
{
  "operations_narrative": "Property submission for Meridian Stores plc, a clothing chain.
  The risk address is one building at 14 King Street, and the broker has left the occupancy box blank.
  The ground floor opens off the high street. It has window displays, a public entrance, tills,
  fitting rooms, and sales staff serving customers during ordinary trading hours. The first floor is
  reached by a public stair and is a further sales floor, with the same garments on rails. The second
  floor and the third floor have no public entrance. Staff reach them from a side door with a pass.
  Those floors are fitted as the chain's regional office: desks for buyers and merchandisers, a finance team,
  human resources, an e-commerce group, meeting rooms, and a boardroom. The people on those floors do not serve
  customers. The covering note says only that the building contains the shop floors and the regional offices,
  and it does not say which use should be coded. No manufacturing, no printing works, no food production,
  and no warehouse serving other branches are described. The goods in the building are the shop's own
  merchandise on the sales floors."
}
Questions:
{
  "building_occupancy": {
    "type": "choice",
    "instructions": "Which occupancy class best fits this building?",
    "criteria": {
      "retail": "A shop selling goods to the public, including the sales floors of a chain.",
      "offices": "Offices for administration, buying, finance, or management, including office floors in the same building as a shop.",
      "storage_of_finished_goods": "A warehouse holding goods for delivery, with no sales floor.",
      "paper_and_cardboard_converting": "Making packaging from paper or board.",
      "woodworking": "Sawing or machining wood.",
      "printing_with_flammable_solvents": "Printing with solvent-based inks.",
      "food_processing": "A business preparing food or drink.",
      "other": "A trade that is none of the classes above.",
      "not_stated": "No use of the building is described."
    }
  }
}
Die Questions tragen die Anweisungen (instructions) und die Kriterien (criteria). State ist ein eigenes Feld.
Antwort:
Antwort:
retail erhält 88 Prozent, und offices 12 Prozent. Die übrigen sieben Klassen, einschließlich other und not_stated, stehen auf null,
weshalb die beiden Anteile zusammen 100 Prozent ergeben. Die Frage verlangt eine Klasse für das Gebäude. Den Ausschlag bei der Entscheidungsfindung geben die Verkaufsflächen: eine Bekleidungskette,
ein Eingang an der Haupteinkaufsstraße, Kassen, Umkleidekabinen und Ware, die dem Publikum zugänglich sind. Die oberen Geschosse sind der Grund, warum offices nicht verschwindet.
Dort befinden sich Einkauf, Finanzen, Personal sowie ein Vorstandszimmer, welches nur mit Mitarbeiterausweis erreichbar ist. Diese Klasse ist so formuliert, dass Bürogeschosse und Laden
sich im selben Gebäude befinden. Das leere Feld für die Nutzungsart wird nicht zu not_stated, weil das Begleitschreiben selbst beide Nutzungen beschreibt. Das Beispiel
lässt Geschossfläche, Bauart und Prämiensatz bewusst heraus.
Choice: "retail"
Confidence liegt bei 86 Prozent und ist ein eigenes Feld neben den Klassenwahrscheinlichkeiten. Der Konfidenzwert gibt an, wie konzentriert die Verteilung ist.
JSON-Antwort aus der Oberfläche von TypeSafe:
{
  "model": "jev-1.13.0",
  "answers": {
    "building_occupancy": {
      "type": "choice",
      "choice": "retail",
      "confidence": 0.86,
      "probabilities": {
        "printing_with_flammable_solvents": 0,
        "other": 0,
        "offices": 0.12,
        "not_stated": 0,
        "storage_of_finished_goods": 0,
        "food_processing": 0,
        "retail": 0.88,
        "paper_and_cardboard_converting": 0,
        "woodworking": 0
      },
      "stats": {}
    }
  },
  "usage": {
    "input_tokens": 739,
    "output_tokens": 107
  },
  "request_id": "playground_1e33fe768144c234a6183ffdda68c62cc6e",
  "evaluation_time_ms": 74.38133600226138
}
Score: Triage der Erstmeldung (FNOL - First Notice of Loss)
Für das Primitiv Score nutze ich eine generische Schaden-Erstmeldung (First Notice of Loss, FNOL) gekoppelt an die Sachpolice eines Gebäudeeigentümers. Der Eigentümer hat dem Versicherer einen Schaden gemeldet, und die Frage ist nun, wie schnell ein Schadensachbearbeiter mit der Schadenbearbeitung beginnen muss. Im Kern handelt es sich dabei um eine Schaden-Triage. Da das Anwedungsbeispiel die Funktionsweise verdeutlichen soll, hat es der Einfachheit halber nur eine Dimension: Es behandelt weder die Reservierung des Schadens, noch einen Gefahrenschlüssel, noch die Abgrenzung zwischen der Gebäude-Deckung und einem möglichen Haftpflichtanspruch der Mieter.
Score liefert einen score, eine legend, welche die selbst gesetzten Stufen wiedergibt, eine Wahrscheinlichkeit je Stufe und einen Konfidenzwert.
Der Score ist das wahrscheinlichkeitsgewichtete Mittel der Stufenindizes, die bei 0 beginnen. Die Stufen müssen aufsteigend geordnet sein, von der
geringsten zur höchsten Schwere, und jede Stufe muss eine konkrete Situation beschreiben. Ein Etikett wie „mittlere Schwere“ gibt dem Modell keinen
Sachverhalt, an dem es den Text festmachen kann. Jede Stufe muss deshalb eine konkrete Situation benennen – die Questions unter dem folgenden State machen dies deutlich.
Anfrage und Antwort
Eingabe
State:
{
  "loss_notice": "Unread overnight email, forwarded by the broker at 06:40.
  The insured owns Hale Court, a three-storey multi-tenant office building.
  The sender is the managing agent. No handler has opened the file.
  From: Priya Shah, Hale Court Management
  To: the broker's claims desk
  Subject: Ceiling leak at Hale Court

  I am writing from the lobby before the building's normal hours.
  Just after five the second-floor tenant rang the out-of-hours number.
  A joint in the ceiling void over their comms room has opened. Their night person
  has switched the cabinets off and taken the night shift out of that room. They
  are standing in the lobby with the door propped so the engineer can see in.
  The tenant on the floor underneath found water on the ceiling tiles above the open-plan desks.
  That tenant has sent the early staff home. The desks under those tiles are empty.
  They have laid plastic sheets across the screens and the printers, and someone from
  their side is waiting in the car park with the keys. Our engineer was in the plant room
  for the morning round and closed the valve on the riser that feeds that void. He says
  the handle is fully over and the pipe on his side of the valve is quiet. He also says
  drops are still falling from the ceiling of the floor below onto the plastic sheets.
  I have not been on either floor. A plumber has been called. I will write again when
  the plumber has been in the void."
}
Questions:
{
  "queue": {
    "type": "score",
    "instructions": "How quickly does a handler need to take this first notice, based only on what the notice says is happening?",
    "criteria": [
      "The event is over. No occupant is out of use, and no injury is mentioned.",
      "Damage is at the insured premises only. The insured can keep operating. No injury is mentioned.",
      "Another occupant is out of use, or the insured's operations have stopped. The narrative says the source is under control. No injury is mentioned.",
      "Water, fire, or collapse is still in progress, or the narrative names an injury."
    ]
  }
}
Die Questions tragen die Anweisungen (instructions) und die Kriterien (criteria), welche in diesem Fall die der Schwere nach aufsteigend sortierten Stufen darstellen. State ist ein eigenes Feld.
Antwort
Antwort:
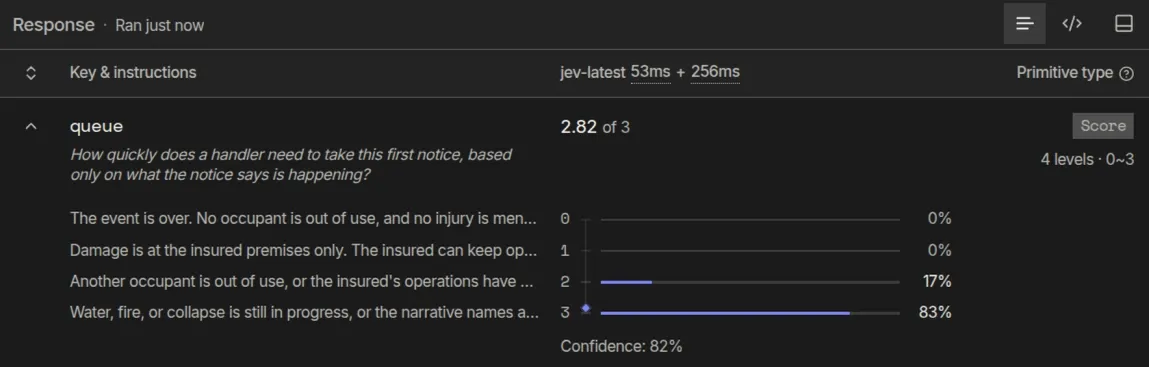
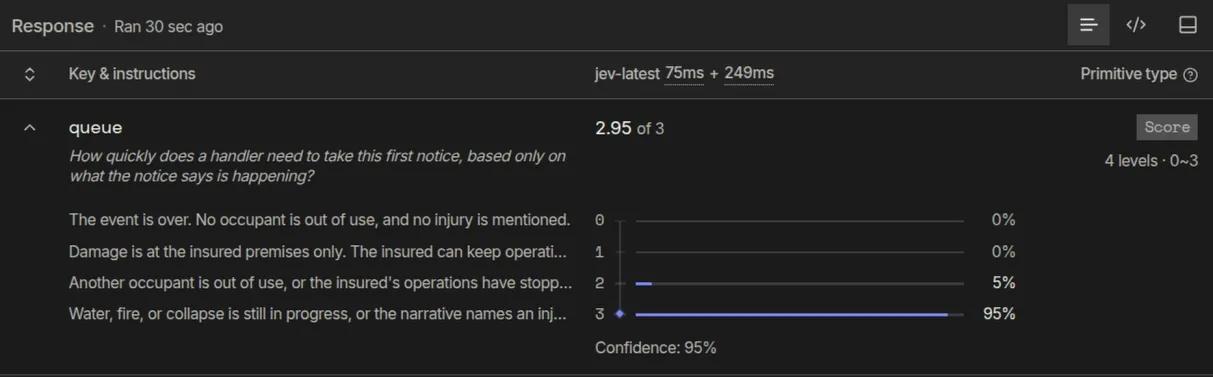
Stufe 3 erhält 83 Prozent. Das ist die Stufe für einen Wasseraustritt, der noch andauert. Stufe 2 erhält 17 Prozent. Das ist die benachbarte Stufe, auf der andere Nutzer ihre
Räume verlassen haben und die Meldung die Ursache als unter Kontrolle beschreibt. Stufe 0 und Stufe 1 stehen auf null, sodass die beiden Anteile 100 Prozent ergeben.
Der zurückgegebene Score ist 2,82. Er ist das wahrscheinlichkeitsgewichtete Mittel der Indizes. Auf den ausgegebenen Wahrscheinlichkeiten ergibt 0.17 × 2 + 0.83 × 3 den Wert 2,83.
Die Differenz von einem Hundertstel liegt an der Rundung dieser beiden Wahrscheinlichkeiten.
Die Wahrscheinlichkeit von 83 Prozent kommt daher, dass aus der Decke des darunterliegenden Geschosses noch Tropfen auf die Abdeckfolien fallen. Die Meldung nennt keine Verletzten. Stufe 2 behält einen Anteil, weil dieselbe E-Mail auch eine andere Lesart zulässt: Die Nachtschicht hat den Serverraum verlassen, die Frühschicht im Geschoss darunter ist nach Hause gegangen, der Ventilgriff ist vollständig umgelegt (geschlossen), und das Rohr auf der Seite des Haustechnikers läuft/tropft nicht. Ich würde diese E-Mail an vordere Stelle priorisieren, vor eine Meldung, in der Personen lediglich ihre Räume verlassen haben und die Ursache als unter Kontrolle beschrieben wird. Die Schränke im Serverraum werden für die Reserve und für ein Sublimit von Bedeutung sein, was über die Summen im Schadensystem gerechnet wird. Die Gefahrenart und die Abgrenzung zwischen Gebäude-Deckung und einem Haftpflichtanspruch der Mieter werden in dieser Frage nicht behandelt, denn der Score priorisiert lediglich die Meldungen.
Score: 2.82
Confidence: 0.82 Der Konfidenzwert liegt bei 82 Prozent. Er ist ein eigenes Feld neben den Stufenwahrscheinlichkeiten. Jede Stufenwahrscheinlichkeit ist ein Balken, und der Konfidenzwert ist eine Zahl für das Muster dieser Balken. Ein hoher Wert heißt, dass die Balken ungleich sind. Der Wert ist nicht die Höhe des höchsten Balkens und auch keine zweite Wahrscheinlichkeit dafür, dass die Stufe stimmt.
Die Legende gibt die Kriterien in der übergebenen Reihenfolge wieder, von 0 aufwärts. Jede Stufe enthält die Wahrscheinlichkeit, die das Modell ihrem Index gegeben hat.
Wahrscheinlichkeiten:
- 0: 0,
- 1: 0,
- 2: 0.17,
- 3: 0.83
JSON-Antwort aus der Oberfläche von TypeSafe:
{
  "model": "jev-1.13.0",
  "answers": {
    "queue": {
      "type": "score",
      "score": 2.82,
      "legend": {
        "0": "The event is over. No occupant is out of use, and no injury is mentioned.",
        "1": "Damage is at the insured premises only. The insured can keep operating. No injury is mentioned.",
        "2": "Another occupant is out of use, or the insured's operations have stopped.
              The narrative says the source is under control. No injury is mentioned.",
        "3": "Water, fire, or collapse is still in progress, or the narrative names an injury."
      },
      "confidence": 0.82,
      "probabilities": {
        "0": 0,
        "1": 0,
        "2": 0.17,
        "3": 0.83
      },
      "stats": {}
    }
  },
  "usage": {
    "input_tokens": 719,
    "output_tokens": 17
  },
  "request_id": "playground_1e306c1396c6c4b404fa7268963c45e9140",
  "evaluation_time_ms": 52.74227600602899
}
Noul: Zeichnungsausschlüsse erkennen
Noul ist der einfachste der drei Primitive. Man formuliert eine Aussage und Jev liefert die Zahl noul: Die Wahrscheinlichkeit, dass die Antwort ja lautet.
Ein Wert nahe 1 steht für ein deutliches Ja, nahe 0 für ein deutliches Nein, und 0,5 bedeutet, dass das Modell unsicher ist. Eine Noul-Antwort enthält keinen Konfidenzwert.
Eingesetzt wird Noul, wenn die Frage lautet, ob ein Sachverhalt vorliegt, oder nicht, und nicht etwa, welche Klasse zutreffend ist. Ein Choice verbraucht seine Wahrscheinlichkeit immer innerhalb der Liste. Ein Noul kann niedrig sein. Diese Beschreibung benutzt das Wort „Recycling“ an keiner Stelle. Der physische Vorgang ist gleichwohl Verwertung von Stoffen, also jene Betriebsart, die viele Zeichnungsrichtlinien in der Sachversicherung einschränken oder ablehnen. Welche Risiken der Versicherer zeichnen will, legt er selbst fest. Noul stellt nur fest, ob der Sachverhalt tatsächlich vorliegt. In den Kriterien steht die Richtlinie, samt der wörtlichen Beschreibungen, die auf Slips durchaus auftauchen.
Anfrage und Antwort
Eingabe
State:
{
  "state": "The insured runs a regional consolidation centre for retail packaging. Mixed post-consumer plastic and cardboard arrive from stores, are sorted on site,
  baled, and sold on to reprocessors. A small office overlooks the yard."
}
Questions:
{
  "material_recovery": {
    "type": "noul",
    "instructions": "Is this location sorting, baling, or otherwise processing post-consumer waste or secondary raw materials?",
    "criteria": {
      "true": "The location sorts, bales, shreds, or otherwise processes post-consumer waste, scrap, or secondary raw materials. Wording such as consolidation centre,
      logistics hub, or packaging recovery still counts when that processing is described.",
      "false": "The location stores or hauls intact finished goods and does not open, sort, or bale a waste stream."
    }
  }
}
Die Questions enthalten die Anweisungen (instructions) und die Kriterien (criteria), also true und false. State ist ein eigenes Feld.
Antwort
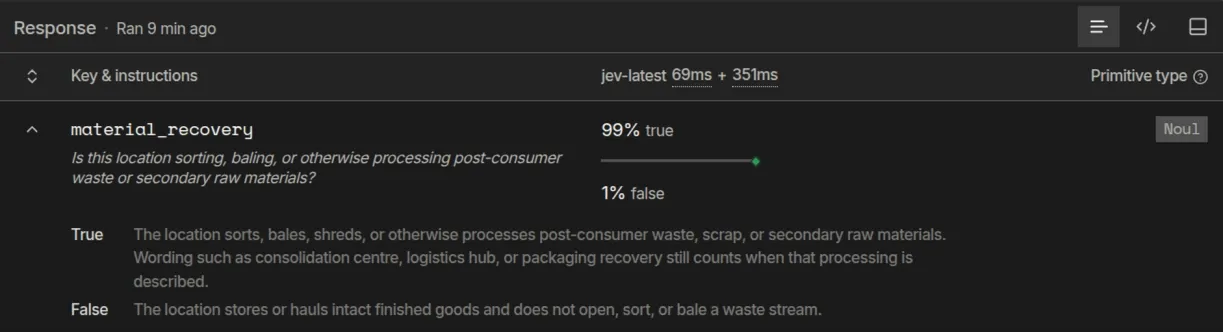
Ein Wert von 0,99 ist ein deutliches Ja: Die Beschreibung sagt, dass die Ware aus dem Post-Consumer-Bereich kommt, sortiert, zu Ballen gepresst wird und an Verwerter verkauft wird. Es ist eine einzelne Vorhersage. Eine Gruppe von Vorgängen mit dem Kennzeichen 0,99 sollte überwiegend richtig liegen, kann aber trotzdem Fehlklassifikationen enthalten. Deshalb ist auch ein hoher Wert von 0,99 keine Sicherheit, um eine Submission ohne menschliche Prüfung abzulehnen. Eine Ausnahme kann nur dann gemacht werden, wenn der Versicherer diesen Wert an eigenen Slips gemessen hat und "sicher" als Schwellenwert vorgeben kann. Nichtsdestotrotz ist hinsichtlich automatischer Ablehungen Vorsicht geboten, selbst dann, wenn ein zweiter Noul bestätigt, dass der Betrieb konkret genug beschrieben ist, um ihn zu klassifizieren. Das Human-In-The-Loop-Prinzip sollte dennoch garantiert sein, denn ein knapp beschriebenes „Logistikzentrum“ ohne beschriebenen Prozess sollte durch einen Underwriter geprüft werden, auch wenn die Antwort zu einem Ausschluss rät.
Dieselbe Anfrage kann mehrere solcher Fragen beinhalten, und ein Workflow kann je ausgeschlossenem Betrieb und je benannter Gefahr einen Noul-Wert in Bezug auf dieselbe Textstelle enthalten. PML, Kapazität, Deckungssummen und alle weiteren numerischen Schwellen bleiben außen vor und werden in einem anderen Teil des Workflow-Codes behandelt. Eine unsichere Wahrscheinlichkeit wird einem Underwriter zu Prüfung vorgelegt. Eine automatische Ablehnung, falls ein Versicherer sie überhaupt einsetzt, verlangt eine hohe Ja-Wahrscheinlichkeit für genau diesen Ausschluss plus einen separaten Noul, der bestätigt, dass die Beschreibung konkret genug für eine Klassifikation ist. Beide Schwellenwerte legt der Versicherer fest. Eine State-Anfrage ist ein kostengünstiger Aufruf, denn Output-Token kosten nichts. Die veröffentlichten Aufrufzeiten des Modells liegen unter einer Sekunde, variieren aber je nach Payload und Standort des Users. Das Parsen des Dokuments liegt außerhalb der Aufrufzeit.
JSON-Antwort aus der Oberfläche von TypeSafe:
{
  "model": "jev-1.13.0",
  "answers": {
    "material_recovery": {
      "type": "noul",
      "noul": 0.99,
      "stats": {}
    }
  },
  "usage": {
    "input_tokens": 424,
    "output_tokens": 23
  },
  "request_id": "playground_1e3a9952ddde54a471fa0e481877b449990",
  "evaluation_time_ms": 38.57667299962486
}
Fazit
Jev könnte Komponenten in bereits bestehenden Workflows ersetzen. TypeSafe beschreibt es als Machine-to-Machine-Modell, weshalb es im Zusammenhang mit Large Language Models ideal eingesetzt werden kann. Das LLM bereitet den Text auf oder entwirft ihn, übermittelt diesen samt definierter Fragen an Jev, welches wiederum seine Entscheidung ausgibt. Das LLM kann diese Entscheidung verwenden und den nächsten Schritt im Workflow ausführen. Hinsichtlich der Beispiele ist zu beachten, dass Choice zur Nutzungsart oben nur eine sehr kurze Liste ist. Choice fasst höchstens 255 Optionen. Die von Typesafe veröffentlichte Klassifikationsleitlinie setzt verlässliches Verhalten näher bei 240 Elementen an. Eine reale Auflistung von Betriebsarten kann aber mehr als 500 Zeilen lang sein, daher muss eine Liste dieser Größe in Form einer Hierarchie von Choice-Fragen ausgestaltet sein. Mit Zeichnungsrichtlinien verhält es sich ähnlich: Underwriting Guidelines können gut und gerne mehrere hundert Seiten umfassen. Diese Punkte sind bei der Ausgestaltung der Questions ebenso zu berücksichtigen, wie die Tatsache, dass Jev 64.000 Token pro Anfrage verarbeiten kann3.
FAQ
Wer hat Jev entwickelt?
Jev wurde von dem KI-Startup TypeSafe entwickelt, gegründet von Diogo Almeida, Erik Gafni und Sasha Sheng. Das Modell wurde am 15. September 2026 im Early Access veröffentlicht, die aktuelle Version ist 1.13.
Was ist Jev?
Jev ist ein System-One-Modell. Es fällt ein schnelles Urteil über einen State, den man übergibt, und liefert zu jeder Question, die neben diesem State gesendet wird, eine streng typisierte Entscheidung. Der State ist der Text. Die Questions stehen getrennt. Jede Antwort ist ein Choice, ein Score oder ein Noul, mit den Wahrscheinlichkeiten, die unten beschrieben sind.
Was ist der State?
Der State ist der Text, den Jev beurteilt. Er kann ein String, ein JSON-Objekt oder ein Array aus Texten sein. Bilder, Audio und Video werden zurückgewiesen. Questions sind ein eigenes Feld der Anfrage.
Was gibt jedes Primitiv zurück?
Choice ist eine Option aus einer ungeordneten, geschlossenen Menge. Die Rückgabewerte sind choice, probabilities und confidence.
Score ist eine Position auf einem geordneten Bewertungsraster, das man selbst schreibt, vom geringsten zum höchsten, mit 2 bis 10 Stufen, indiziert ab 0. Die Rückgabewerte
sind score, legend, probabilities und confidence. Der Score ist das wahrscheinlichkeitsgewichtete Mittel der Stufenindizes und kann zwischen zwei Stufen liegen.
Noul ist die Antwort auf „Trifft diese Aussage zu?“. Der Rückgabewert ist eine Gleitkommazahl von 0 bis 1, die Wahrscheinlichkeit, dass die Antwort ja lautet. Noul gibt keinen Konfidenzwert zurück.
Worin unterscheiden sich Jev und LLMs in Versicherungs-Workflows grundlegend?
Large Language Models lesen Text und erzeugen Text, Token für Token. Ein Workflow muss anschließend ein Label aus diesem Fließtext parsen, wobei der Fließtext falsch sein kann oder es zu Halluzinationen kommen kann. Jev ist ein nicht-generatives Entscheidungsmodell. Es liefert einen von drei Antworttypen (Primitiven): ein Choice unter Optionen, die man vorgibt, ein Score auf Stufen, die man vorgibt, oder ein Noul, die Wahrscheinlichkeit für Ja. Es entsteht kein Satz, also gibt es nichts zu parsen, und ein Versicherungssystem oder ein Sprachmodell daneben kann die Felder direkt lesen. Die Antwort bleibt in dem Schema, das man deklariert hat. Die gewählte Option kann trotzdem die falsche sein, und derselbe Aufruf kann von Mal zu Mal ein leicht abweichendes Ergebnis ausgeben. Mehrere Triage-Fragen werden in einem Durchgang bewertet. Die veröffentlichten Aufrufzeiten liegen unter einer Sekunde und variieren abhängig vom Payload und dem Standort des Users. Der Preis für den Input liegt bei 0,042 USD je Million Token. Output-Token werden nicht abgerechnet, was deutlich günstiger ist, als für erzeugten Text zu bezahlen. Jev liest die Form der Question und liefert die passende Form der Antwort.
Welches sind die wichtigsten Agentic-AI-Anwendungsfälle für Jev in der Versicherungsbranche?
Typesafe listet mögliche Use-Cases für unterschiedliche Wirtschaftsbereiche auf, wobei diese lediglich erste gebrainstormte Ideen sind. Für die Versicherungsbranche werden das Schadenmanagement und die Risikobewertung als mögliche Anwendungsbereiche genannt. Ferner werden Underwriting-Workflows im Zusammenhang mit probabilistischen Indikatoren erwähnt. Ein veröffentlichtes Produkt für Underwriting-Submissions steht nicht dahinter. Was folgt, ist meine Lesart davon, wo die drei Primitive passen.
Bei einer Erstmeldung kann ein Choice eine Schilderung in eine Sparte einordnen, und ein Score kann die Priorisierung der Schadenmeldungen vornehmen, wobei diese Schweregrade beschrieben sein müssen. Die Schadenhöhe wird an anderer Stelle im Code verarbeitet. Dunkelverarbeitung ist ebenfalls Codesache. Eine Auszahlung ist nur zulässig, wenn die semantischen Prüfungen im definierten Wertebereich für Annahmen liegen und der Betrag, die Datumsangaben und Limits im Bestandssystem durchgehen. Jev liefert die semantischen Prüfungen. Das Bestandssystem verantwortet die Zahlung, wobei ich streng dazu rate eine Zahlungsfreigabe durch einen Menschen vorzusehen, um das Human-In-The-Loop-Prinzip zu gewährleisten.
Im Underwriting würde ich es für die Appetite-Triage einer Submission einsetzen, nachdem das Paket auf die maßgeblichen Textstellen reduziert wurde: ein Noul je ausgeschlossenem Betrieb oder je benannter Gefahr und ein Choice über die Liste der Nutzungsarten, die der Tarif tatsächlich verwendet, mit einer ausdrücklichen Option „not stated“. Ein Mensch prüft das unsichere Band. Ein Score auf einer Dimension kann die Warteschlange ordnen. Straight-through Processing bleibt eine UND-Verknüpfung im eigenen Code des Versicherers.
Dringlichkeit und Eskalation folgen bei eingehendem Text von Versicherungsnehmern demselben Muster. Ein Score sagt, wie dringend die Nachricht ist, und der Code markiert, was das gesetzte Band erfüllt. Die Eignung sehe ich bei Klassifikation, Erkennung und Priorisierung von Text und bei Wahrscheinlichkeiten, die als Merkmale in ein Risikomodell eingehen, das der Versicherer bereits verantwortet. Pricing, PML, Kapazität und Kompetenzgrenzen bleiben außerhalb des Modells.
Welche Kontrollen des operationellen Risikos sind nötig, wenn Versicherungsvorgänge an Jev delegiert werden?
Bänder an den eigenen gelabelten Vorgängen. Bei einem Noul legt man die Ja-Wahrscheinlichkeit in Bänder. Eine Wahrscheinlichkeit nahe 0,5 steht für Unsicherheit und sollte einem Underwriter
vorgelegt werden. Eine automatische Ablehnung, falls man sie nutzt, verlangt eine hohe Ja-Wahrscheinlichkeit bei einem Ausschluss plus eine separate Prüfung der Konkretheit, und beide Schwellen
legt der Versicherer fest. Auch hier rate ich aber nach wie vor zur Einhaltung des Human-In-The-Loop-Prinzips. Bei Choice und Score liest man die Wahrscheinlichkeit der gewinnenden Option und den Konfidenzwert.
Der Konfidenzwert misst, wie konzentriert die Verteilung ist. Die Kalibrierung ist, wie TypeSafe sie beschreibt, eine Eigenschaft der Wahrscheinlichkeiten über die Gruppe: Eine Gruppe mit dem Kennzeichen 0,8
sollte über viele Vorhersagen hinweg in etwa 80 Prozent der Fälle stimmen, und ein einzelner Fall bei 0,8 kann trotzdem der falsche sein. Ein konzentrierter Fall mit geringer Auswirkung kann nur
dann direkt durchlaufen, wenn die übrigen Gates im Code bestehen. Das mittlere Band geht an einen Menschen.
Die Arithmetik bleibt im Code. Prämien, Selbstbehalte, Limits, Abschreibung, PML, Kapazität und Gesamtversicherungssummen sind gewöhnliche Berechnungen.
Leitplanken für geschlossene Optionen. Ein Kategorisierungsschema braucht eine ausdrückliche Option needs_review oder other, damit ein unscharfer Vorgang in eine Prüfgruppe läuft, die man
selbst definiert hat.
Ist Jev in allen Sprachen gut?
Nein. Englisch ist die primäre Trainingssprache, und auf englischem Text ist die Genauigkeit derzeit am höchsten. Andere Sprachen werden ebenfalls unterstützt, sind aber weniger genau. Ein deutscher Benchmark ist nicht veröffentlicht. Versicherer im englischen Sprachraum können bereits mit MVPs starten, alle anderen sollten die Schwellenwerte für die Vorlage zunächst an den eigenen Vorgängen messen.
Wie sichert man die Prüfbarkeit und senkt das allgemeine Risiko beim Einsatz von Jev in der Versicherung?
Einen Audit-Trail führen. Request-ID, Namen der Questions, Instructions, Versionen der Criteria, die Wahrscheinlichkeiten und die Schwelle protokollieren, die der Code angewendet hat. Den rohen
State nicht ins Log schreiben, da Submissions und Schadennotizen Kundendaten enthalten können.
Jev führt kein Chain-of-Thought-Reasoning aus und liefert keine eingebaute Begründung. Bei einem Choice oder einem Score erzeugt das Modell die Verteilung über die Optionen oder Stufen, die man
vorgegeben hat. Bei einem Noul erzeugt es die einzelne Ja-Wahrscheinlichkeit. Was eine Person nachvollziehen kann, ist nur dieses Ergebnis.
Die Manipulation von Dokumenten ist ein Risiko. Erfundener oder irreführender Text kann die Wahrscheinlichkeiten verschieben. Das Modell behandelt den State nicht als fraud-Eingabe. Dokumente
sind in einer unabhängigen Schicht zu prüfen, bevor man diese oder deren Inhalt im State verwendet.
Quellen
- TypeSafe: Wer eines der Beispiele TypeSafes Playground ausführen will, muss einen Account anlegen und danach im Reiter Billing ein Zahlungsmittel hinterlegen. Es müssen mindestens 5 USD Guthaben aufgeladen werden. Dieses reicht zum Testen allemal aus, denn Jev ist deutlich kostengünstiger als übliche LLMs.
- Gemäß dem OpenAI DevDay 2026 Recap (https://openai.com/index/devday-2026-recap/) exisitiert eine begrenzte Vorschau. Die Aktualisierung des Posts verwendet den Decisions-Leitfaden (https://developers.openai.com/api/docs/guides/decisions): öffentliche Beta, gpt-6-luna, POST /v1/decisions, Antworttypen predicate, choice, score und refusal, Eingabe 0,10 USD je Million Token, Ausgabe-Token werden nicht abgerechnet.
- TypeSafe beschreibt auf seiner Models-Seite (https://docs.typesafe.ai/models) im Absatz "Context length" die beiden relevanten Tokengrenzen: 64.000 Token für den gesamten Aufruf, also State plus alle Questions, und 32.000 Token für den State plus die längste Question.